大模型测评基准II:视觉文本基准
1. 综合视觉理解
| 名称 | 发布时间 | 简介 | 规模 | 评测指标 | |||||||||||||||||||||||||||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
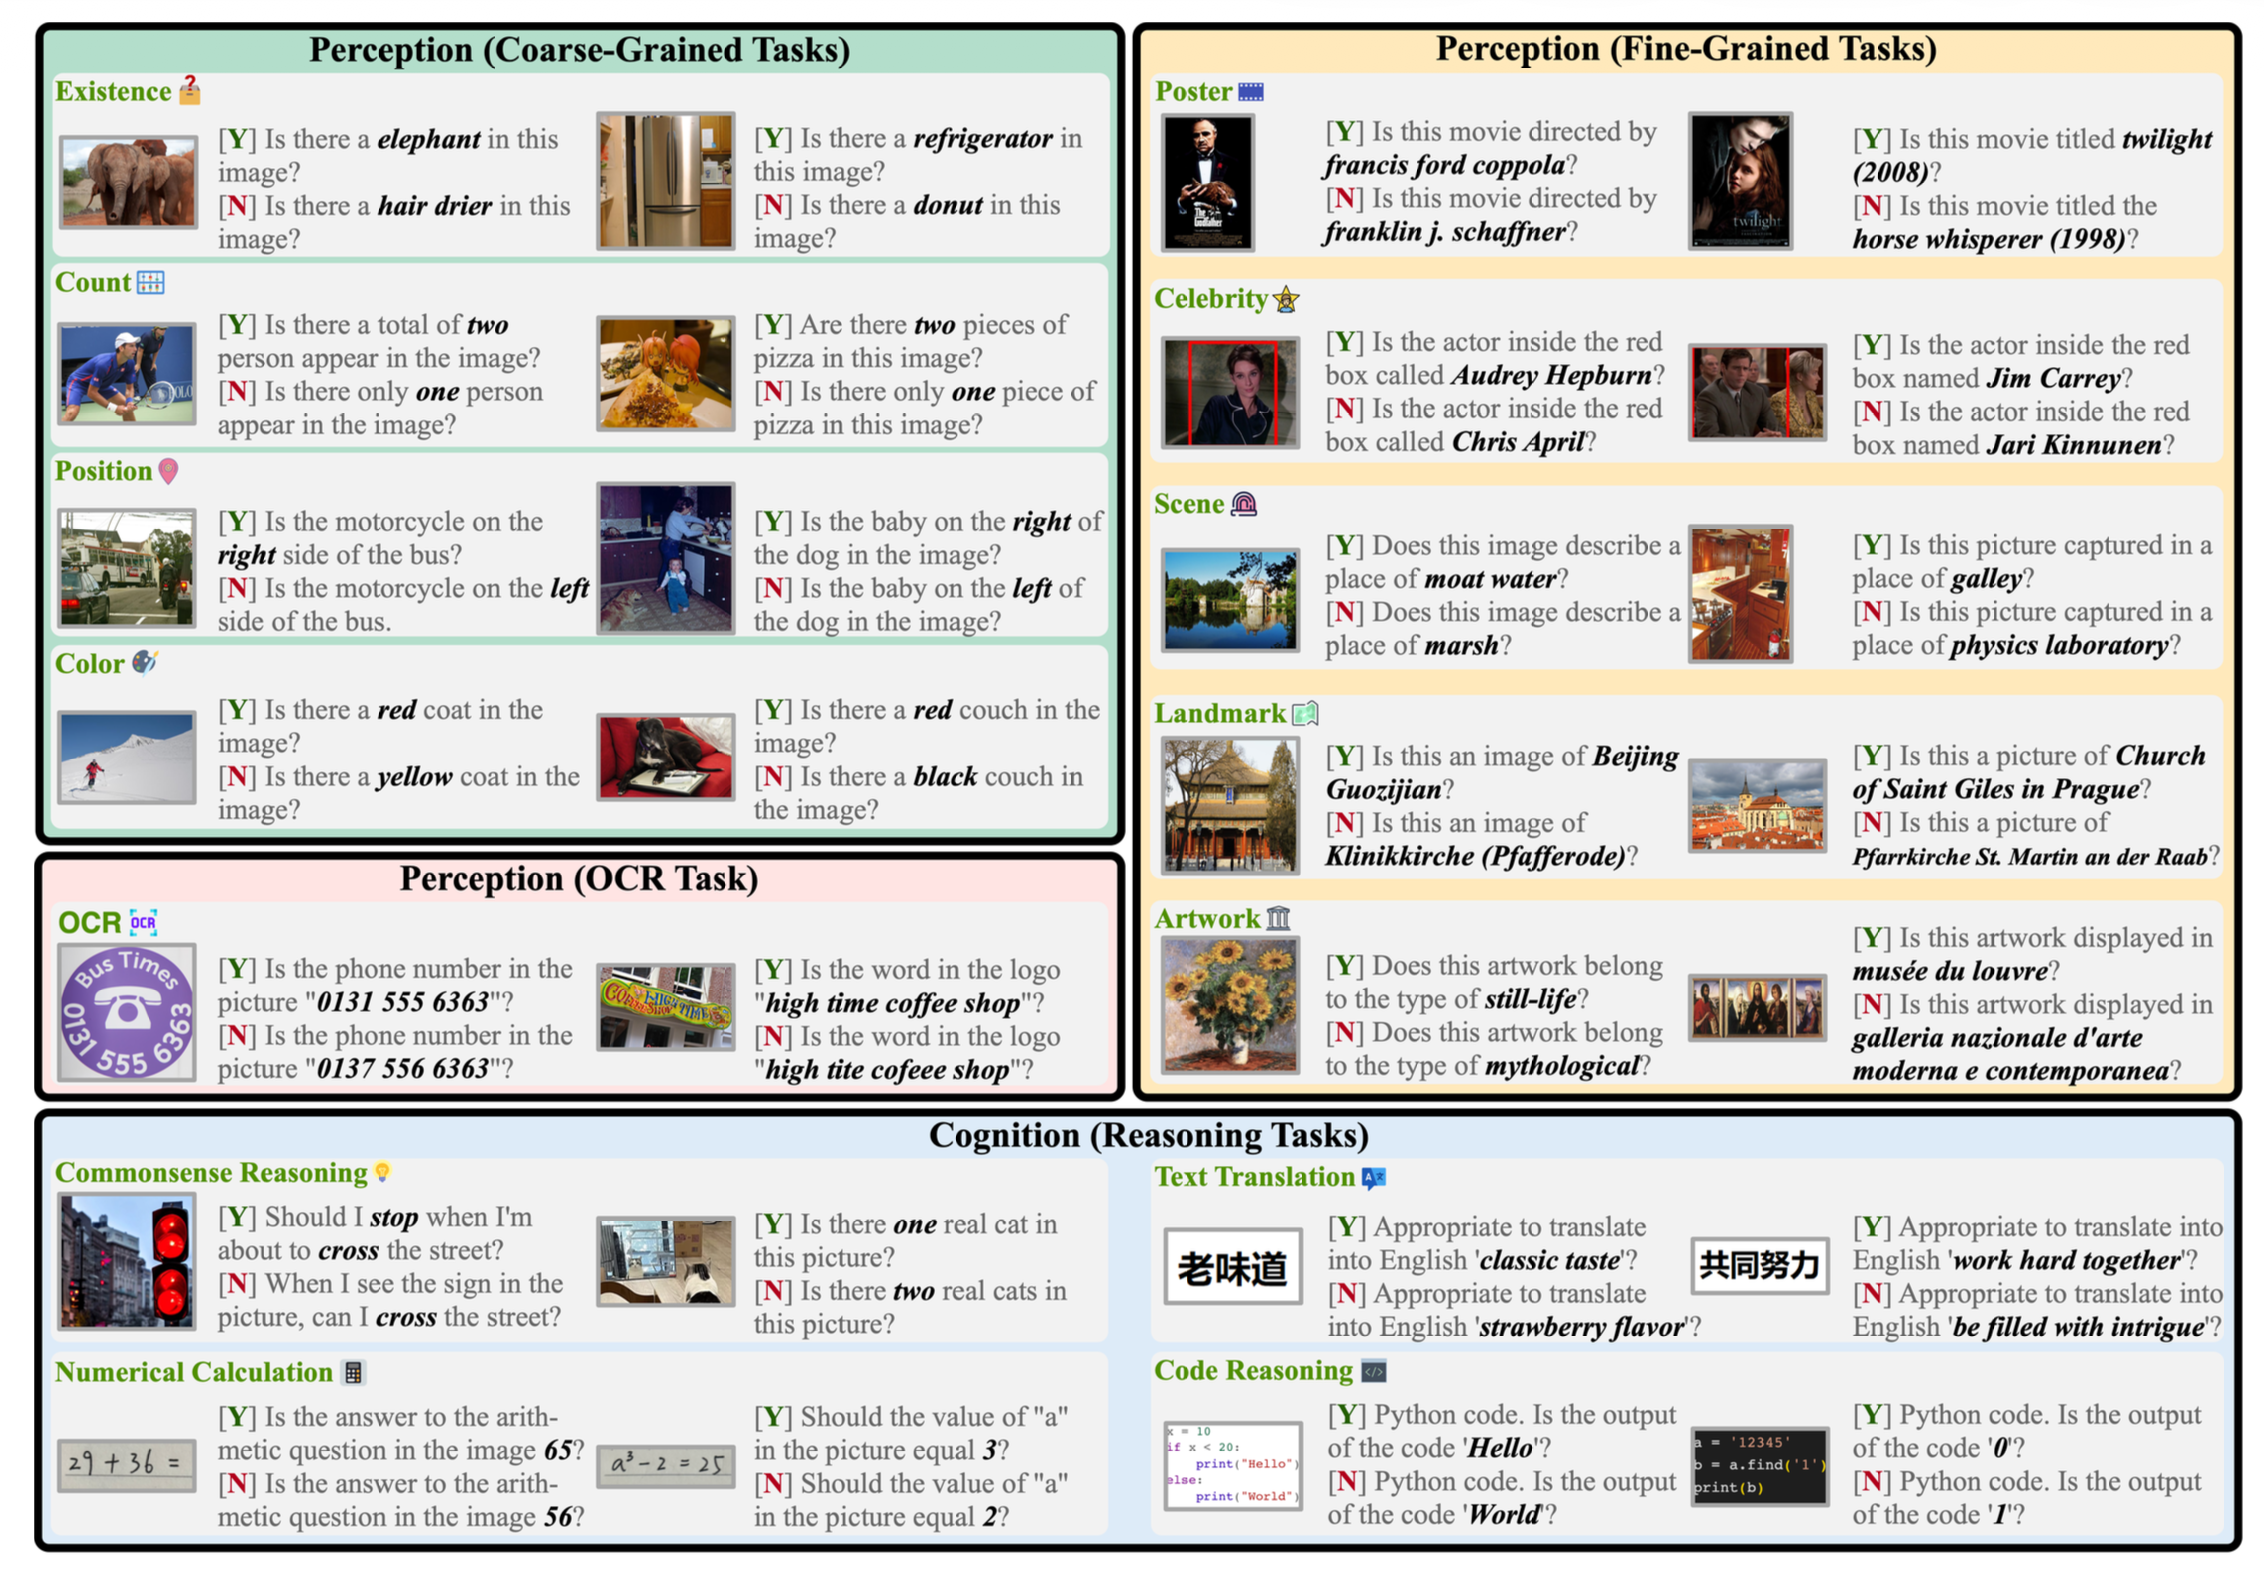
| 2023 年 | 包含感知和认知两大维度、共 。所有题目均采用 Yes/No 二分类形式,每张图像对应一正一负两道问题,最终以汇总分数 Score 衡量模型表现。 | 图像:1,187 问题:2,374 | Score | ||||||||||||||||||||||||||||||||||||||||||||||
| |||||||||||||||||||||||||||||||||||||||||||||||||
| Fu et al. MME: A Comprehensive Evaluation Benchmark for Multimodal Large Language Models. arXiv:2306.13394, 2023。论文链接。 最终得分为 Accuracy 与 Accuracy+ 的总和(Score = Accuracy + Accuracy+,Sum);Accuracy 是单题准确率,Accuracy+ 是同一图像对应两题均答对的比例。
| |||||||||||||||||||||||||||||||||||||||||||||||||
 | |||||||||||||||||||||||||||||||||||||||||||||||||
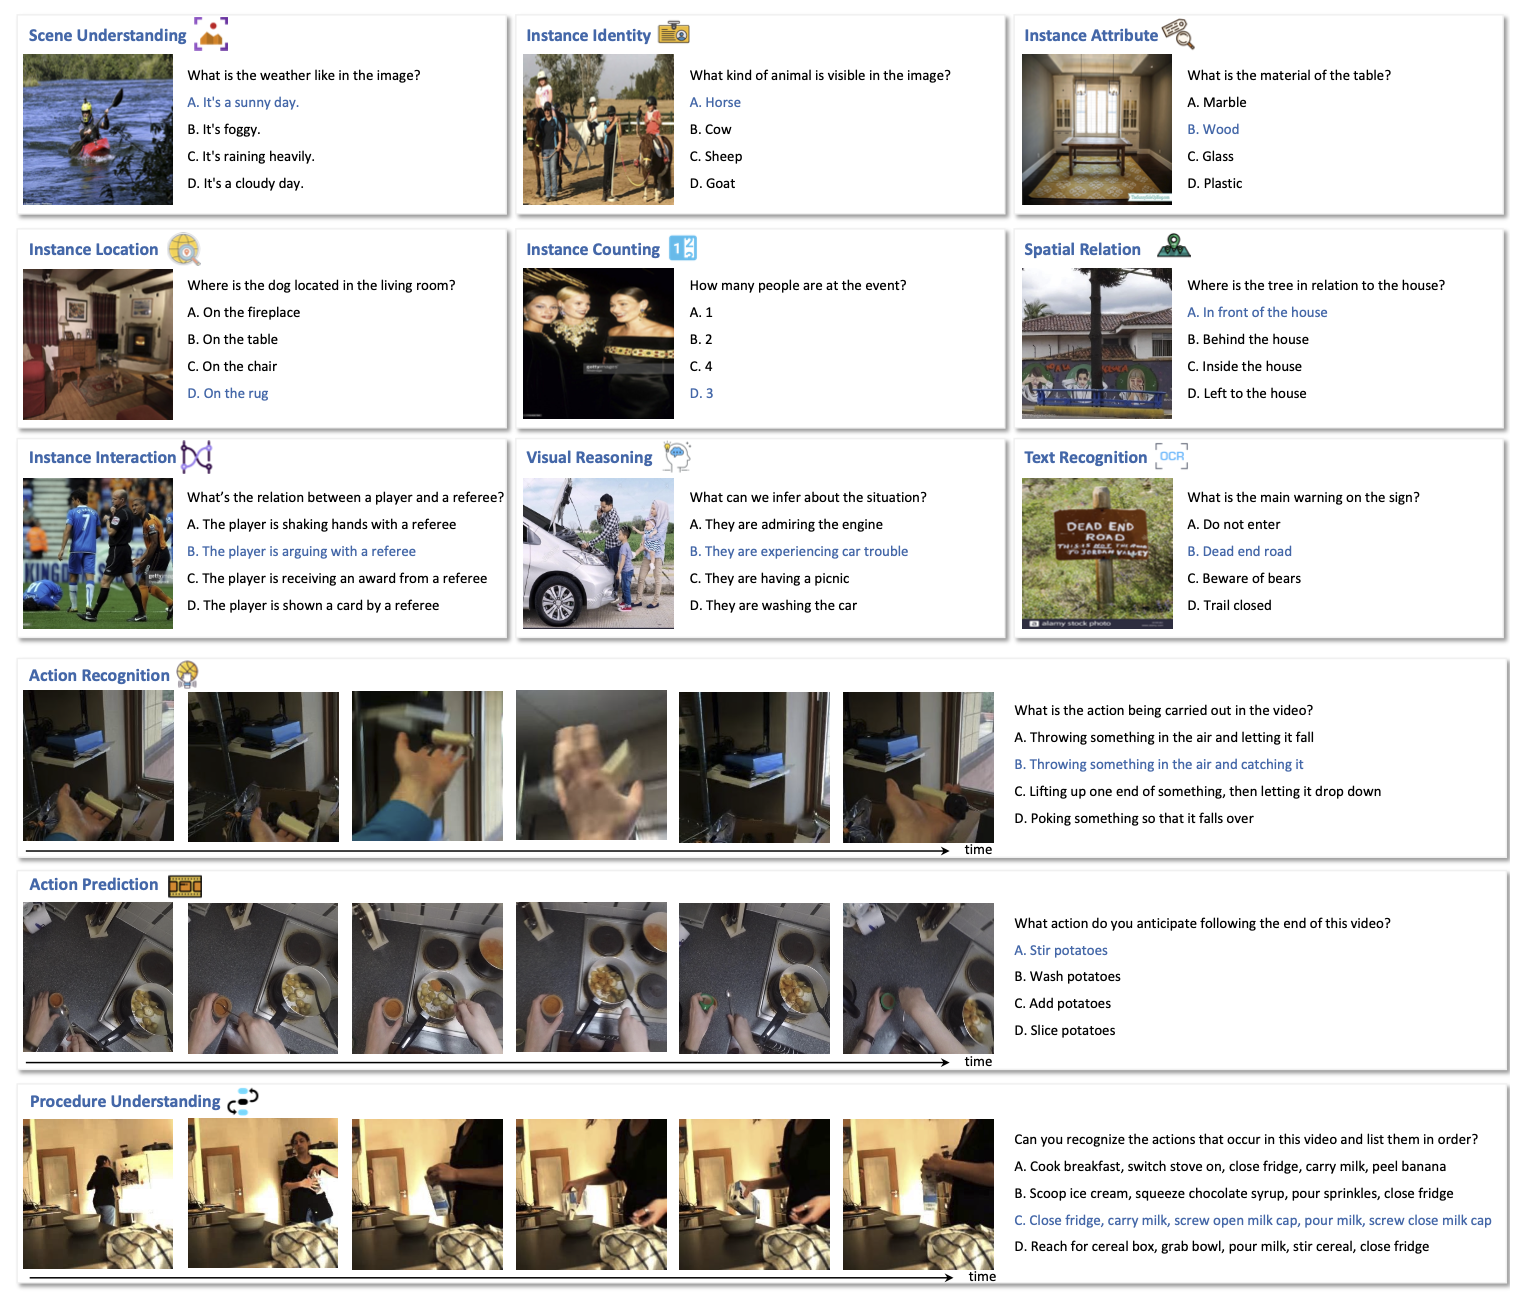
| 2023 年 | 包含。采用人工验证的四选一选择题,评估模型的视觉感知、空间推理与时序理解能力。相比MME,SEED-Bench 样本数量更多,覆盖范围更广。 | 问题:19K | Accuracy | ||||||||||||||||||||||||||||||||||||||||||||||
| |||||||||||||||||||||||||||||||||||||||||||||||||
| Li et al. SEED-Bench: Benchmarking Multimodal LLMs with Generative Comprehension. arXiv:2307.16125, 2023. 论文链接 · 官方仓库。 注:规模采用原论文 Table 1 的 19,242 道选择题,包含 9 个图像空间理解维度与 3 个视频时序理解维度。原论文采用候选答案似然排序确定预测选项,并以 Accuracy 评估。 | |||||||||||||||||||||||||||||||||||||||||||||||||
 | |||||||||||||||||||||||||||||||||||||||||||||||||
2. 文本与图表理解
| 名称 | 发布时间 | 简介 | 规模 | 评测指标 |
|---|---|---|---|---|
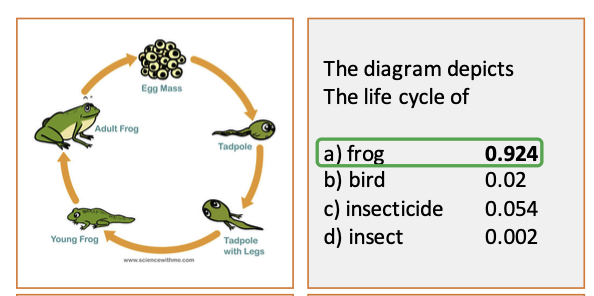
| 2016 年 | 小学科学示意图的视觉问答基准,采用四选一选择题。 | 图像:5,000+ 问题:15,000+ | Accuracy | |
| Kembhavi et al. A Diagram Is Worth A Dozen Images. CVPR, 2016. arXiv:1603.07396. 论文链接。 任务形式:输入科学示意图与自然语言问题,输出四个候选选项中的正确答案。主要考察图表元素识别、实体关系理解与科学知识推理。 数据规模:包含 5,000+ 张科学示意图和 15,000+ 道问答题;其中训练集 4,000 张图像,测试集 1,000 张图像。 | ||||
 | ||||
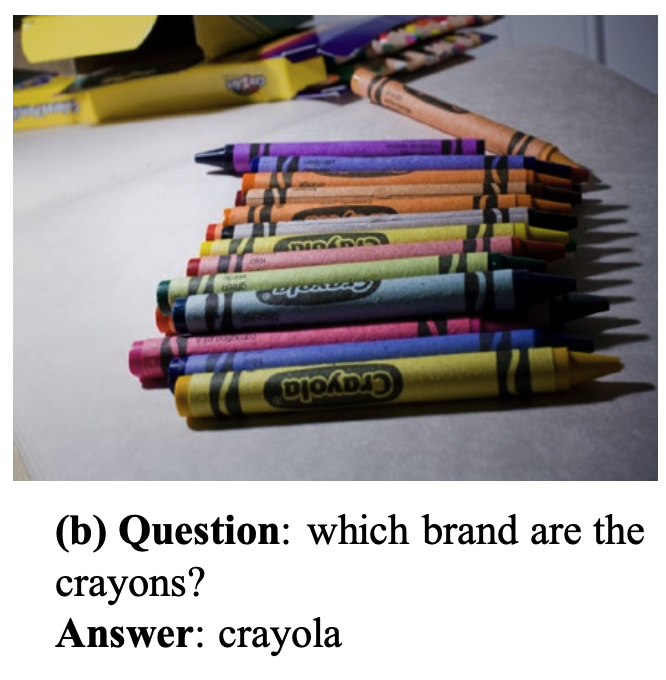
| 2019 年 | 自然场景中包含文字的图像问答基准,回答开放式问题。 | 图像:3,289 问题:5,734 | VQA Accuracy | |
| Singh et al. Towards VQA Models That Can Read. CVPR, 2019. 论文链接 · 数据集主页。 规模按 TextVQA 0.5.1 测试集统计。 | ||||
 | ||||
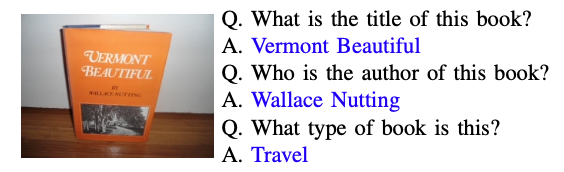
| 2019 年 | 书籍封面的文字驱动视觉问答基准,回答开放式问题。 | 图像:约 20.8K 问题: 100K | Accuracy | |
| Mishra et al. OCR-VQA: Visual Question Answering by Reading Text in Images. ICDAR, 2019. 论文链接 · 数据集主页。 数据集构成:OCR-VQA-200K 包含 207,572 张书籍封面图像和 1,002,146 个问答对,平均每张图像对应 4.83 个问题;包含 117,378 位作者、203,471 个书名、32 种图书类别和 320,794 个不同答案。Train / Val / Test 按 80% / 10% / 10% 划分,测试集约 100K 个问答对。 问题类型:Book Title(书名)、Author Name(作者)、Book Genre(类别)、Year(出版年份)和 Edition(版本)。书名、作者和类别是主要任务;年份与版本仅在部分封面中出现。问题基于模板生成,并经人工改写以增加表达多样性。 评测指标:Accuracy,即预测正确的问题占比。论文报告的最佳基线模型 BLOCK+CNN+W2V 整体准确率为 48.3%;二分类问题为 58.2%,书籍类别识别为 22.0%,作者识别为 42.9%。 | ||||
 | ||||
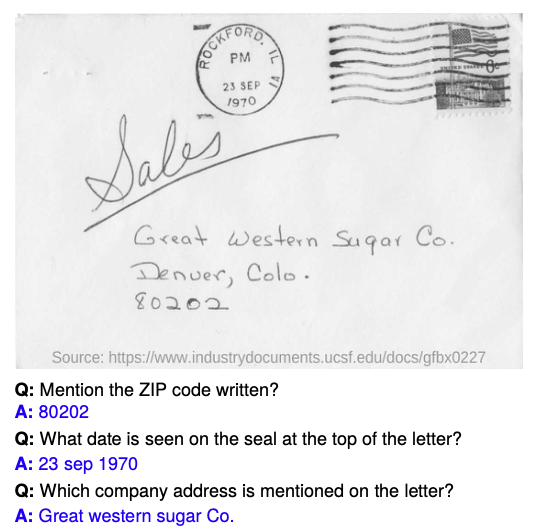
| 2021 年 | 真实文档图像的文档视觉问答基准,图像来自工业文献档案库,覆盖。 | 图像:1,287 问题:5,188 | ANLS / Accuracy | |
| 工业文献档案库覆盖以下 5 个行业:
| ||||
| Mathew et al. DocVQA: A Dataset for VQA on Document Images. WACV, 2021. 论文链接。 数据规模:测试集 5,188 个问题、1,287 张图像;完整数据集 50,000 个问题、12,767 张图像。数据划分:Train / Val / Test = 80% / 10% / 10%。 ANLS(Average Normalized Levenshtein Similarity):基于编辑距离计算预测答案与标准答案的相似度,降低 OCR 拼写错误等细微差异带来的惩罚。 Accuracy:预测答案与任意一个 Ground Truth 完全匹配的比例。 | ||||
 | ||||
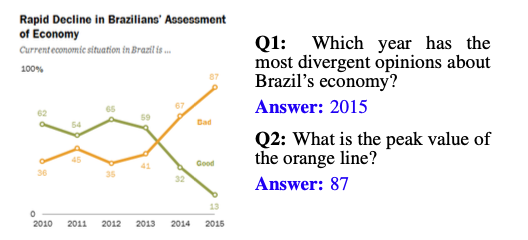
| 2022 年 | 真实世界图表的视觉问答基准,回答开放式问题。 | 图像: 1.6K 问题:2,500 | Relaxed Accuracy | |
| Masry et al. ChartQA: A Benchmark for Question Answering about Charts with Visual and Logical Reasoning. Findings of ACL, 2022. 论文链接。 数据集构成:ChartQA-H 包含 9,608 个由人工编写的问答对;ChartQA-M 包含 23,111 个基于人工撰写图表摘要、由 T5 自动生成的问答对。全数据集共 20,882 张真实世界图表,来源包括 Statista、Pew Research、Our World in Data(OWID)和 OECD。 问题类型:Data Retrieval(13.0%)、Visual(10.7%)、Compositional(43.0%)、Visual & Compositional(33.3%)。 Relaxed Accuracy:数值答案与标准答案的误差在 5% 以内即视为正确;非数值答案采用 Exact Match。 ChartQA 不仅要求读取图表文本或数值,也考察结合视觉属性与底层数据进行组合推理,例如比较数据差异、计算平均值或寻找最大值。 | ||||
 | ||||
3. 传统视觉问答
| 名称 | 发布时间 | 简介 | 规模 | 评测指标 | |||||||||||||||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
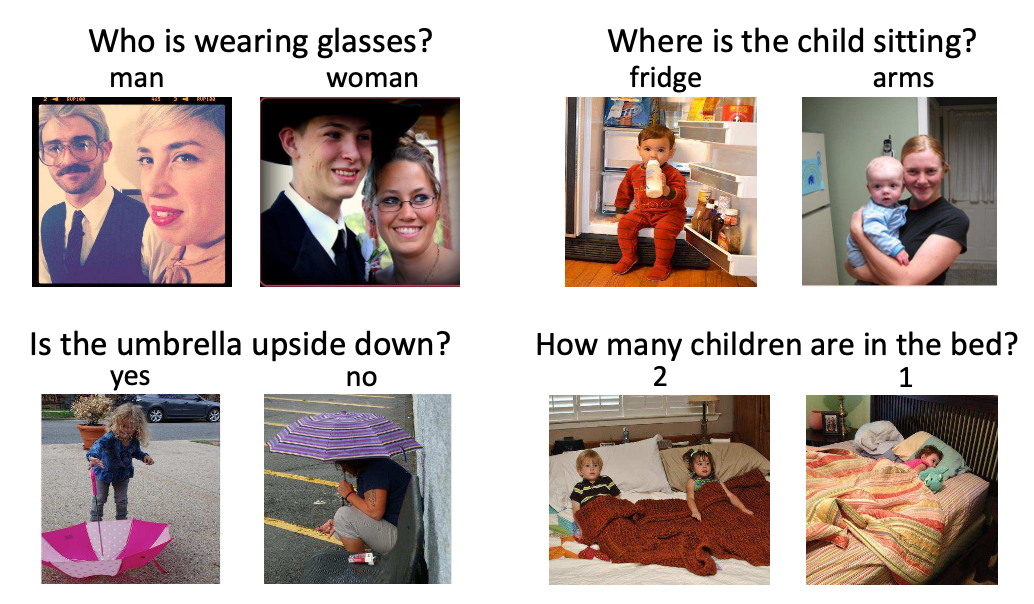
| 2017 年 | 通用开放式视觉问答基准,给定图像和自然语言问题,要求模型结合视觉信息、语言理解与常识知识生成答案。 | 图像:81,434 问题:447,793 | VQA Accuracy | ||||||||||||||||||||||||||||||||||
| Goyal et al. Making the V in VQA Matter: Elevating the Role of Image Understanding in Visual Question Answering. CVPR, 2017. 论文链接 · 数据集主页。 数据集构成:VQAv2.0 完整数据集包含 204,721 张 COCO 图像、1,105,904 个问题和 11,059,040 个人工标注答案。训练集包含 443,757 个问题,验证集包含 214,354 个问题,测试集包含 447,793 个问题。 | |||||||||||||||||||||||||||||||||||||
 | |||||||||||||||||||||||||||||||||||||
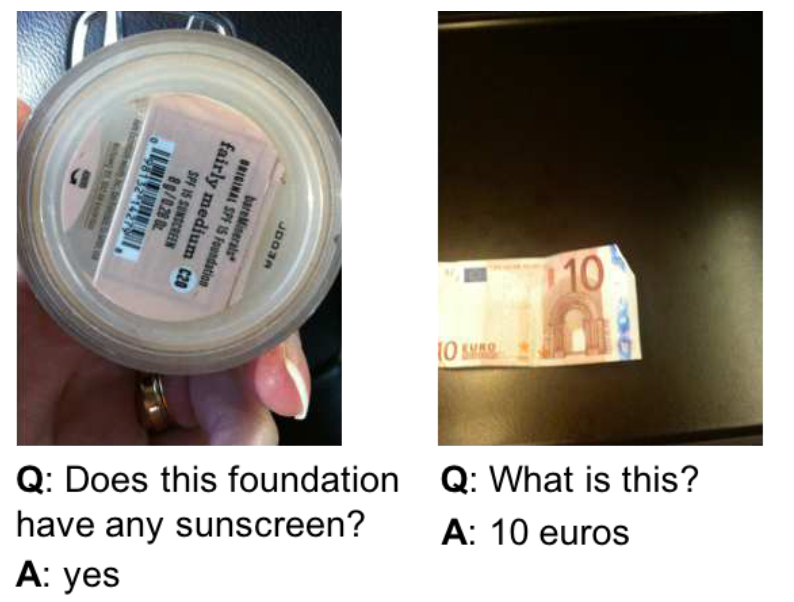
| 2018 年 | 面向视障人士的真实场景视觉问答基准,由视障用户使用手机拍摄图片并口述问题。 | 问题:31,173 | VQA Accuracy 等 | ||||||||||||||||||||||||||||||||||
| Gurari et al. VizWiz Grand Challenge: Answering Visual Questions from Blind People. CVPR, 2018. 论文链接。 | |||||||||||||||||||||||||||||||||||||
 | |||||||||||||||||||||||||||||||||||||
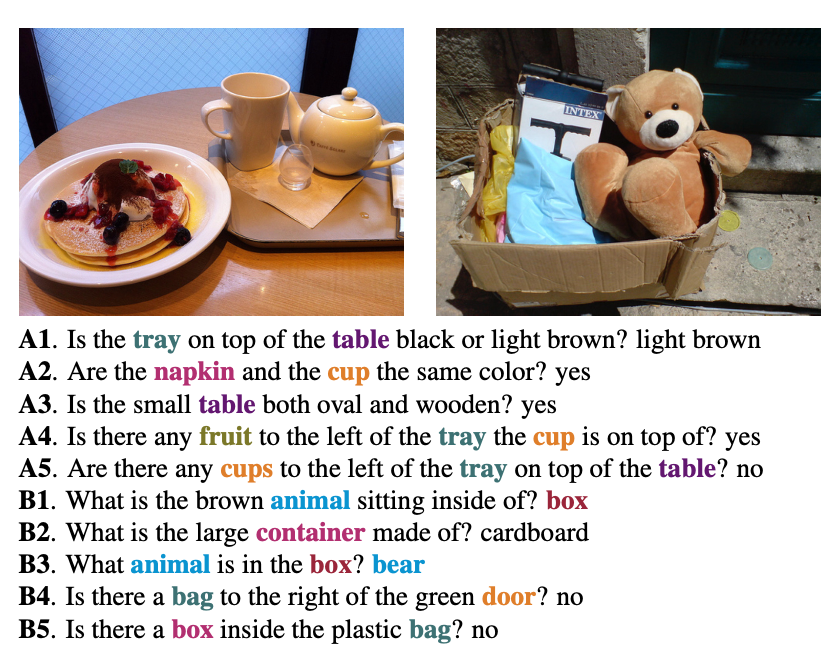
| 2019 年 | 基于 Visual Genome 场景图自动生成的组合式视觉问答数据集,通过遍历物体、属性及关系构造多样化问题。 | 图像:113K 原始问题:22.67M | Accuracy | ||||||||||||||||||||||||||||||||||
| Hudson et al. GQA: A New Dataset for Real-World Visual Reasoning and Compositional Question Answering. CVPR, 2019. 论文链接。 | |||||||||||||||||||||||||||||||||||||
 | |||||||||||||||||||||||||||||||||||||
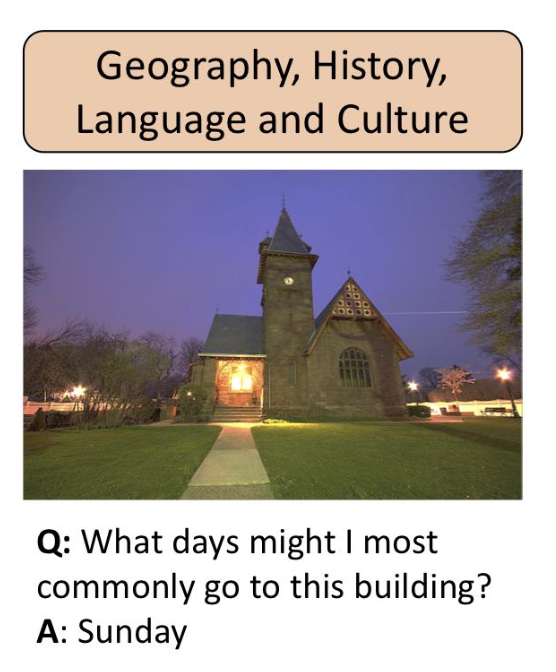
| 2019 年 | 面向外部知识(Outside Knowledge VQA)的视觉问答基准,要求模型结合图像内容与外部世界知识回答问题。涵盖 。 | 图像:14,031 问题:14,055 | VQA Accuracy | ||||||||||||||||||||||||||||||||||
| |||||||||||||||||||||||||||||||||||||
| Marino et al. OK-VQA: A Visual Question Answering Benchmark Requiring External Knowledge. CVPR, 2019. arXiv:1906.00067。 | |||||||||||||||||||||||||||||||||||||
 | |||||||||||||||||||||||||||||||||||||